开发方案
数据中台、业务规则中台、智能体中台独立设计,最后开发一个集成中台,集成中台作为统一入口,底层通过HTTP、MCP协议调用各个中台数据,完成业务操作。
架构图
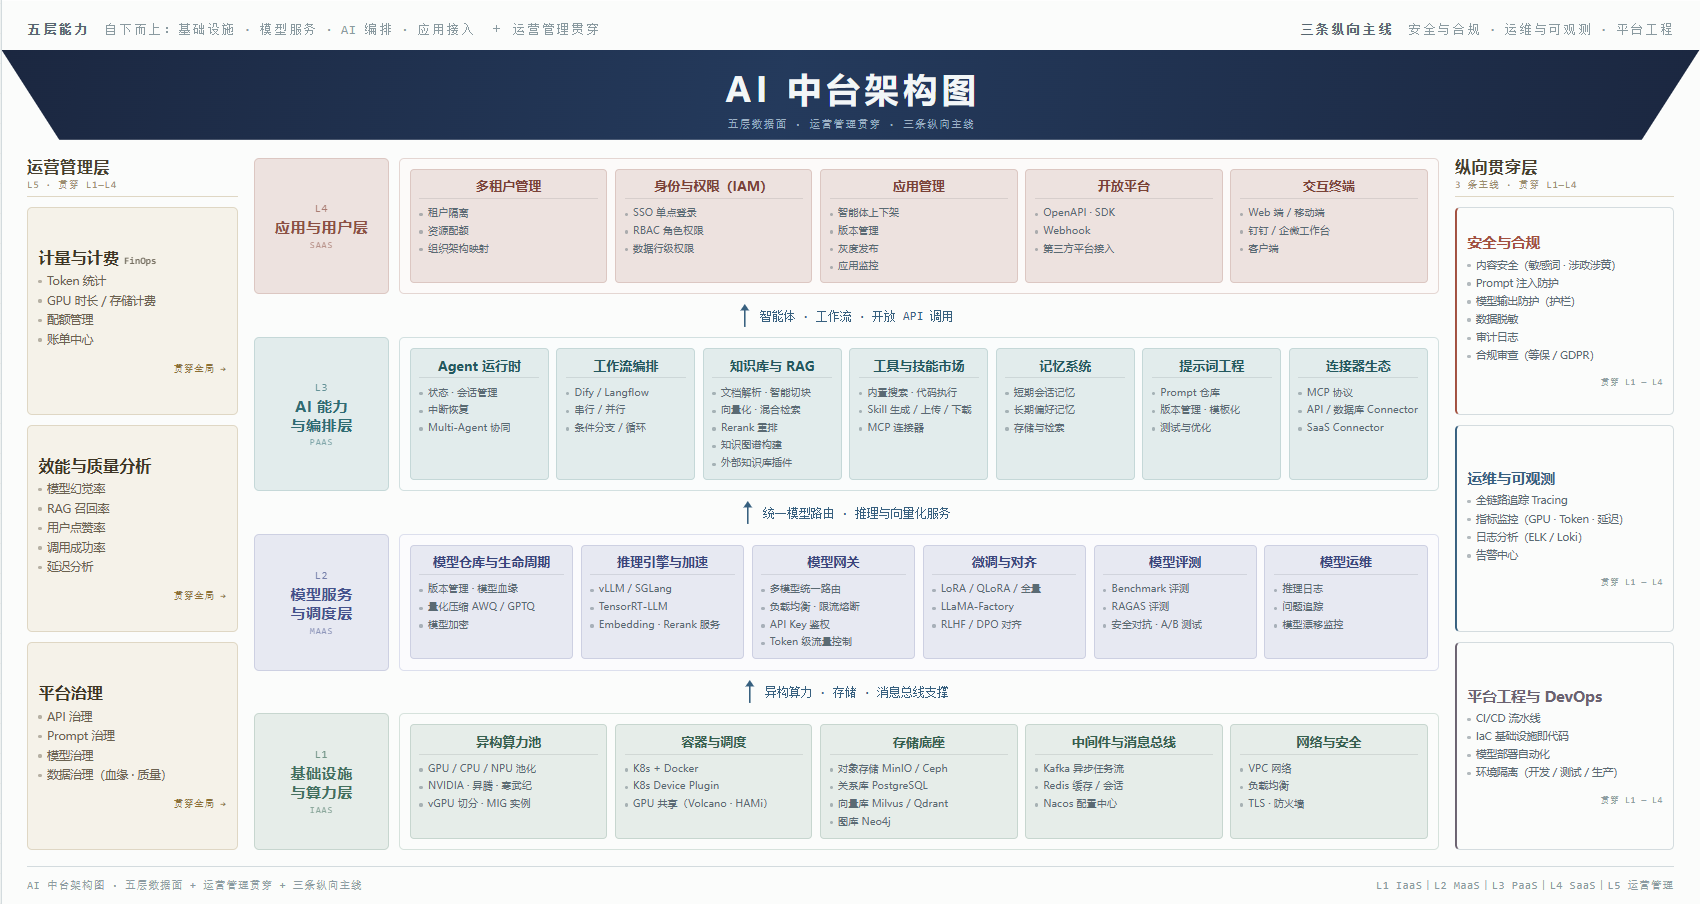
架构图解释
-
异构算力
“异构算力”就是把市面上各种不同架构、不同品牌的AI芯片(CPU/GPU/NPU)统一管理起来,形成一个巨大的“算力资源池”。向上层(L2 模型服务与调度层)提供标准化的算力支持,避免AI应用被单一硬件厂商绑定,并最大化硬件利用率。 -
MIG(多实例 GPU)
MIG 是 NVIDIA(英伟达)推出的一项硬件级技术:
Multi-Instance(多实例):将一个物理 GPU 分割成多个独立的、完全隔离的 GPU 实例。
GPU(图形处理器):即底层的物理显卡。
允许将一个高端的物理 GPU(例如 A100、H100 等)在硬件层面切分成多个小型的 GPU 实例,每个实例都有自己独立的显存、缓存和计算核心。这样可以让多个小规模的 AI 任务(或不同的用户/租户)同时共享一块大显卡,互不干扰,从而提高算力的利用率(这就是架构图中“池化”和“切分”的具体体现)。 -
k8s容器编排系统的核心能力,对比单纯的docker容器部署:
① 自动扩缩容:
如果资源是自建的(买机器),那么k8s只能省点电费。如果是云服务器,K8s 的自动扩缩容能在低谷时把另外不需要的多台服务器“退还”给云厂商,直接省下真金白银。
② 故障自愈:
单机故障,如果只是容器里的应用崩溃了,Docker 的 restart: always 自启策略确实能把它拉起来。跨机故障(K8s 的核心价值),K8s 监控的是整个集群,它发现 A 挂了,会立刻在 B 服务器上重新启动这个容器,实现真正的自愈。
③ 服务发现与负载均衡:
如果只有2-3台机器,在 compose 文件里加上 external net,让它们在一个网络里靠容器名通信。当你有了几十台机器,且容器会因为扩容、故障转移而不断在不同机器间“漂移”时,K8s 的服务发现可以解决
④ 滚动更新与回滚:发布新版本时,K8s 可以逐个替换旧容器,一旦发现新版本有问题,立刻自动回滚到旧版本,实现零停机部署。